이 블로그는 10월 19일 저녁부터 26일까지 일주일 동안 열리지 않았습니다. 화면에는 502 Bad Gateway 한 줄만 떴습니다. 원인은 비어 있던 도커 재시작 정책이었습니다. 호스팅사가 커널 보안 패치를 하느라 서버를 재부팅했는데, 같은 서버의 다른 서비스는 다시 떴고 이 블로그 컨테이너만 꺼진 채 남아 있었습니다.
부끄러운 이야기부터 하면, 저는 그 일주일 동안 블로그가 꺼진 줄 몰랐습니다. 글을 미리 예약해 두고 운영하다 보니 블로그 화면을 열어 보지 않았고 그사이 예약해 둔 글 두 편도 공개 시각을 넘겼습니다. 저는 IT 회사에서 마케팅을 하는 비개발자이고 이 블로그는 VPS 한 대에 도커로 직접 올려 운영합니다. 2026년 10월 기준으로 원인을 좁힌 순서와 로그를 읽은 방법, 다시 켜고 바꾼 설정을 기록해 둡니다.
502 Bad Gateway가 뜻하는 것과 원인을 좁힌 순서
MDN의 502 설명을 줄이면, 게이트웨이나 프록시 역할을 하는 서버가 뒤쪽(업스트림) 서버에게서 제대로 된 응답을 받지 못했다는 뜻입니다. 제 서버에서는 앞단의 리버스 프록시 하나가 도메인별로 들어온 요청을 각 컨테이너로 넘겨 줍니다. 그러니 502가 떴다면 프록시는 살아서 요청을 받았고 대답하지 않은 쪽은 그 뒤의 블로그 컨테이너입니다.
워드프레스 장애라고 다 같은 화면이 뜨지는 않습니다. 웹 컨테이너는 살아 있고 DB만 꺼졌다면 워드프레스가 직접 “Error establishing a database connection”(데이터베이스 연결 오류) 화면을 띄웁니다. 어쨌든 웹 서버가 대답은 한 셈이죠. 502는 그 단계에도 못 갔다는 신호라서 DB보다 웹 컨테이너 자체를 먼저 봐야 합니다.
제가 원인을 좁힌 순서는 이랬습니다.
- 같은 서버의 다른 서비스가 응답하는지 봤습니다. 정상이었습니다. 서버 전체나 디스크, 네트워크 문제는 아니니 범위가 블로그 컨테이너로 줄었습니다.
- 컨테이너 목록을 열었습니다. 블로그의 워드프레스 컨테이너와 MySQL 8 컨테이너가 둘 다 exited 상태였습니다.
- 두 컨테이너의 종료 코드와 로그 마지막 줄, 그 시각을 확인했습니다.
- 원인을 정리한 뒤에 컨테이너를 시작하고 재시작 정책을 바꿨습니다.
그날 쓰던 PC에는 서버 SSH 접속 설정이 없어서 저는 컨테이너 관리 화면에서 확인했습니다. 터미널이라면 2번은 docker ps -a, 3번은 docker logs --tail 50 컨테이너이름으로 볼 수 있습니다. docker ps -a의 STATUS 칸에는 Exited (0)처럼 괄호 안에 종료 코드가 같이 나옵니다.
로그에 남아 있던 건 정상 종료 신호였습니다
먼저 종료 코드가 0이었습니다. 컨테이너 안의 프로그램이 오류 없이 스스로 끝났다는 뜻입니다. 오류로 죽었다면 0이 아닌 숫자가 남습니다.
로그 마지막 줄도 같은 이야기를 했습니다.
- MySQL:
Received SHUTDOWN from user <via user signal>(08:55:09). 바깥에서 종료 신호를 받고 스스로 내려갔다는 기록입니다. - 워드프레스(Apache):
caught SIGWINCH, shutting down gracefully(08:55:10). 워드프레스 공식 이미지는 Apache 기반이고 컨테이너를 멈출 때 SIGWINCH 신호를 보내도록 만들어져 있습니다. Apache 문서를 보면 이 신호는 처리 중인 요청을 마치게 한 뒤 끄는 graceful stop입니다.
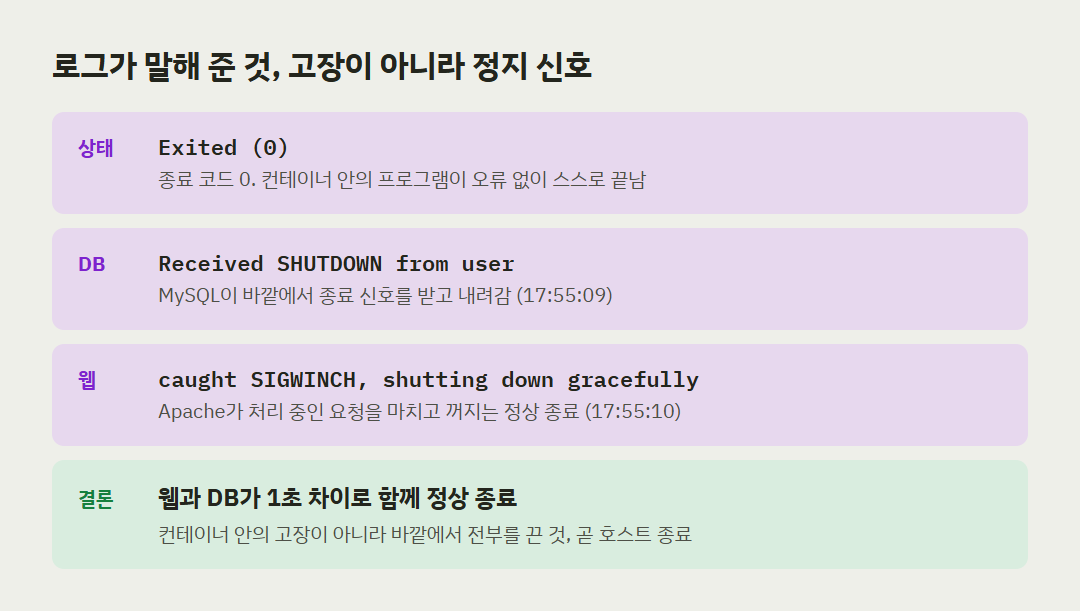
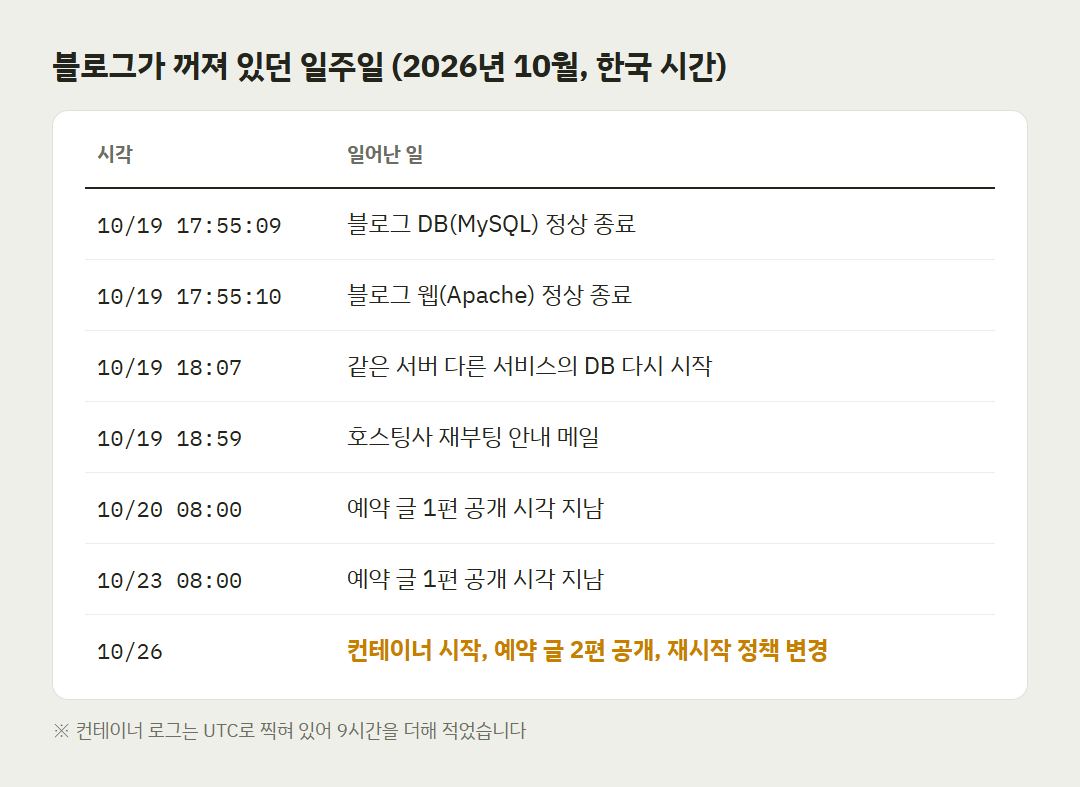
컨테이너 로그는 UTC로 찍혀 있어서 한국 시간은 9시간을 더해야 합니다. 08:55는 한국 시간 17시 55분입니다. 웹과 DB가 1초 차이로 나란히 정상 종료됐다면, 컨테이너 안에서 무언가 고장 난 게 아니라 바깥에서 전부를 끈 겁니다. 서버 자체가 꺼질 때가 딱 이런 모습입니다.
다른 기록도 들어맞았습니다. 같은 서버에 있는 다른 서비스의 DB 컨테이너는 18시 7분에 시작한 기록이 있었습니다. 17시 55분에 꺼지고 약 12분 뒤에 서버가 다시 올라왔다는 계산이 나옵니다. 호스팅사 안내 메일은 그날 18시 59분에 와 있었습니다. 커널 보안 패치로 호스트 재부팅을 진행 중이며, 그 사이 서버가 예고 없이 재시작됐을 수 있다는 사후 안내였습니다.
원인은 비어 있던 도커 재시작 정책
호스트가 재부팅되면 도커 데몬도 같이 내려갔다가 부팅할 때 다시 켜집니다. 이때 어떤 컨테이너를 다시 켤지는 컨테이너마다 붙은 재시작 정책이 정합니다. 같은 서버의 다른 서비스가 18시 7분에 올라왔으니 도커 자체는 정상적으로 켜졌습니다. 다른 점은 정책뿐이었습니다.
이 블로그는 docker compose 파일로 띄웠는데, 웹과 DB 서비스 어디에도 restart 설정이 없었습니다. Compose 파일 문서에 따르면 이때 기본값은 no이고 어떤 상황에서도 컨테이너를 다시 시작하지 않습니다. 평소에는 컨테이너가 계속 떠 있으니 문제가 보이지 않다가 서버가 한 번 재부팅되자 그대로 드러났습니다.
다시 켜고 unless-stopped로 바꾼 과정
10월 26일, 두 컨테이너를 시작하자 블로그가 다시 열렸습니다. 그리고 켜자마자 밀려 있던 예약 글 두 편이 공개됐습니다. 10월 20일과 23일 아침 8시에 나가기로 돼 있던 클로드 코드로 만든 업무 비서 기록과 구글 드라이브 데스크톱 렌더 속도 글입니다. 워드프레스 예약 발행은 WP-Cron이 맡는데, 페이지가 열릴 때마다 실행할 작업 목록을 보고 시각이 지난 작업을 그때 처리합니다. 꺼져 있던 동안 쌓인 예약 공개가 첫 접속에 한꺼번에 처리된 셈입니다. 글 날짜는 원래 예약일로 남았습니다.
그다음 웹과 DB 컨테이너 둘 다 재시작 정책을 unless-stopped로 바꿨습니다. 저는 컨테이너 관리 화면에서 바꿨고, 터미널이라면 이미 떠 있는 컨테이너는 docker update --restart unless-stopped 컨테이너이름 한 줄로 바꿀 수 있습니다. 네 가지 정책을 Docker 공식 문서 기준으로 정리하면 이렇습니다.
| 정책 | 컨테이너가 멈췄을 때 | 직접 멈춘 뒤 도커가 다시 켜질 때 | 이번 같은 호스트 재부팅 |
|---|---|---|---|
| no (기본값) | 다시 켜지 않음 | 다시 켜지 않음 | 꺼진 채 남음 (제 블로그) |
| on-failure | 종료 코드가 0이 아닐 때만 다시 켬 | 다시 켜지 않음 | 다시 켜지지 않음 |
| always | 항상 다시 켬 | 다시 켬 | 다시 켜짐 |
| unless-stopped | 항상 다시 켬 | 다시 켜지 않음 | 다시 켜짐 |
on-failure는 이름만 보면 장애 대비용 같지만 이번 같은 경우는 못 막습니다. 종료 코드가 0이었고 문서에도 도커 데몬이 다시 시작될 때는 컨테이너를 켜지 않는다고 나와 있습니다. always와 unless-stopped는 둘 다 재부팅 뒤에 컨테이너를 다시 켭니다. 차이는 제가 직접 멈춰 둔 컨테이너를 어떻게 다루느냐뿐입니다.
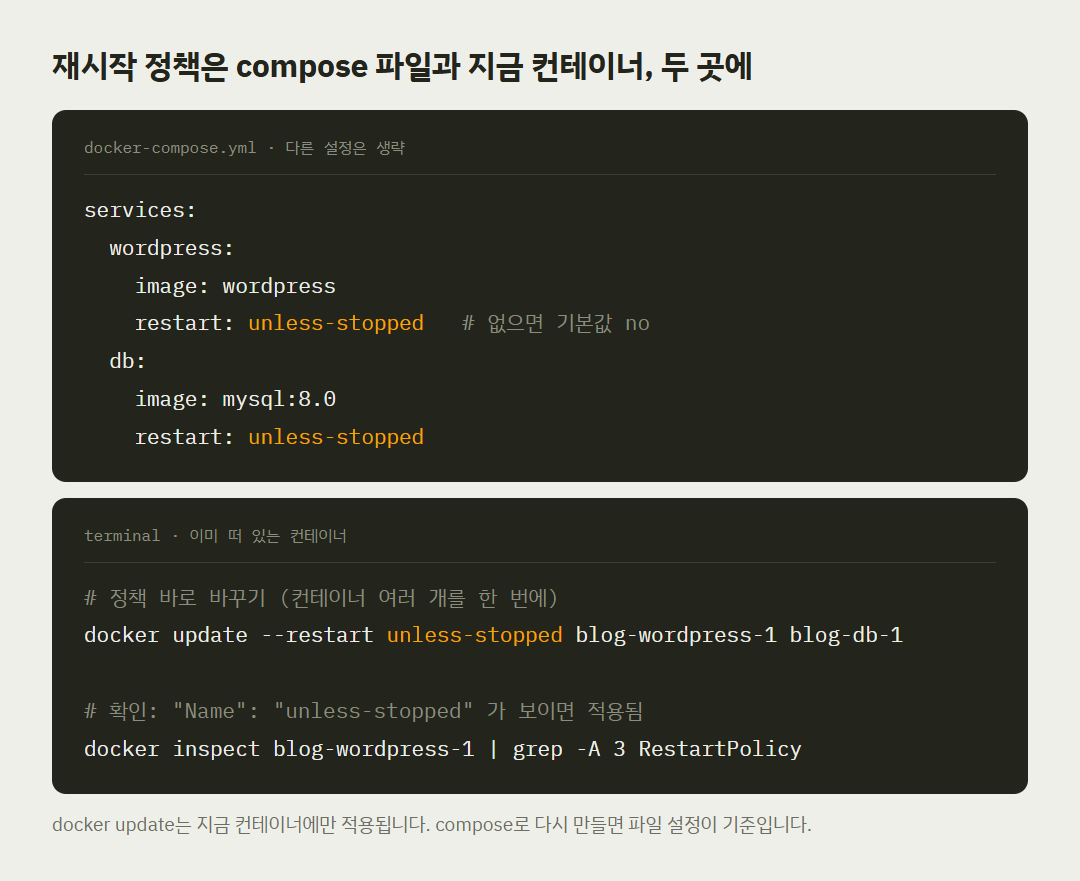
하나 더 남은 일이 있습니다. docker update는 지금 있는 컨테이너의 설정만 바꿉니다. compose로 컨테이너를 다시 만들면 파일 내용이 기준이 되므로, compose 파일의 각 서비스에도 restart: unless-stopped를 넣어야 합니다. 제 서버는 10월 26일 기준으로 컨테이너에는 정책이 걸려 있고 compose 파일은 아직 그대로입니다.
같은 구성을 쓰는 분을 위한 점검 목록
VPS 한 대에 도커로 워드프레스나 다른 서비스를 여러 개 올려 쓴다면 아래를 한 번씩 확인해 보세요.
- 컨테이너마다 재시작 정책을 확인합니다.
docker inspect 컨테이너이름 | grep -A 3 RestartPolicy를 실행해"Name": "no"가 보이면 재부팅 뒤 켜지지 않습니다 - 웹만이 아니라 DB 컨테이너도 봅니다. 웹만 켜지면 502 대신 데이터베이스 연결 오류 화면을 보게 됩니다
- compose 파일의 서비스마다
restart줄이 있는지 봅니다.docker update로 바꿨다면 파일에도 똑같이 적습니다 - 도커 데몬이 부팅 때 켜지는지
systemctl is-enabled docker로 확인합니다. 데몬이 안 켜지면 정책도 소용이 없습니다 - 502가 뜨면 같은 서버의 다른 서비스, 컨테이너 상태(exited와 종료 코드), 로그 마지막 시각 순서로 봅니다. 로그 시각은 UTC인 경우가 많습니다
- 호스팅사에서 점검이나 재부팅 메일이 오면 그날 사이트를 직접 열어 봅니다
- 바깥에서 주기적으로 접속을 확인해 알려 주는 장치가 없으면 저처럼 일주일을 모르고 지나갈 수 있습니다
- 예약 글이 밀려 있었다면 다시 켜는 순간 한꺼번에 공개된다는 점도 알아 둡니다
자주 묻는 질문
always와 unless-stopped 중 무엇을 고르면 되나요?
호스트 재부팅 뒤에 다시 켜 준다는 점은 같습니다. 차이는 직접 멈춘 컨테이너입니다. always는 제가 멈춰 둔 컨테이너도 도커 데몬이 다시 시작되면 켜고 unless-stopped는 멈춘 상태를 그대로 둡니다. 블로그처럼 점검할 때 일부러 꺼 둘 일이 있는 서비스라면 unless-stopped가 다루기 편합니다. 제 블로그도 unless-stopped로 설정했습니다.
실행 중인 컨테이너에서 바꾼 정책을 compose 파일에도 넣어야 하나요?
넣어야 합니다. docker update는 지금 떠 있는 컨테이너에만 적용됩니다. compose로 컨테이너를 다시 만들면 파일에 적힌 설정이 기준이라서 restart 줄이 없으면 다시 기본값 no가 됩니다.
재시작 정책을 걸었는데도 재부팅 뒤 컨테이너가 안 켜지면요?
세 가지를 봅니다. 먼저 도커 데몬이 부팅 때 켜지는지 확인합니다. Debian과 Ubuntu는 기본으로 켜지지만 다른 배포판은 systemctl enable docker가 필요할 수 있습니다. 다음으로 정책이 on-failure인지 봅니다. on-failure는 데몬이 다시 시작될 때 컨테이너를 켜지 않습니다. 마지막으로 Docker 문서에 따르면 재시작 정책은 컨테이너가 최소 10초 떠 있었던 뒤부터 적용됩니다. 켜자마자 꺼지는 컨테이너라면 정책보다 설정과 로그부터 확인해야 합니다.